
Edição #1
A IA saiu do chat: Claude Dashboards, GPT-6 e o Jev
Na primeira edição semanal: o Claude agora monta painéis com os seus dados, o GPT-6 chega a todo mundo no ChatGPT, o Jev mostra uma IA que só escolhe, um placar dos principais modelos e o modelo que eu mais uso hoje.
Davi Carneiro


Antes de qualquer notícia: obrigado. Você deu o seu e-mail para um projeto que ainda estava saindo do papel, e eu não levo isso como pouca coisa. Esta é a primeira edição semanal da introducing.news, e eu estou muito empolgado de, enfim, colocar ela no mundo.
Foram meses de preparo até aqui: definir o formato, testar ferramentas, conversar com gente que trabalha e pesquisa tecnologia e, principalmente, achar um jeito de explicar o que acontece na área sem enrolação e sem tecniquês. A ideia é simples. Você lê com calma, entende de verdade e sai sabendo o que fazer com isso no seu trabalho, seja numa agência, num escritório de advocacia, no RH, no financeiro, na sala de aula ou num time de produto.
E a semana ajudou. Se tem um fio que liga as notícias, é este: a IA está saindo da caixinha de conversa. Ela começou a montar painéis, apresentações, calculadoras e animações, e até a tomar pequenas decisões sem escrever uma linha. Bora ver o que já dá para usar.
Em 30 segundos
- O Claude agora monta painéis com os dados da sua empresa. O Claude Dashboards, lançado na quinta (8), transforma uma pergunta comum em gráficos que se atualizam sozinhos. E criar documentos, apresentações e designs dentro do Claude saiu da fase de testes, inclusive no plano grátis.
- O GPT-6 chegou ao ChatGPT para todo mundo, também no plano grátis, com respostas que viram gráficos, botões e calculadoras.
- O Google colocou um agente do Gemini dentro do Gmail, do Docs e do Sheets, com versões em teste para finanças e jurídico.
- O Jev viralizou por fazer o contrário do ChatGPT: não conversa, só escolhe. É rápido e barato, mas tem limites que vale conhecer.
- No placar dos modelos, a disputa no topo está apertada, e a diferença de custo entre o mais barato e o mais caro passa de 30 vezes.
- Minha recomendação: o DeepSeek V4.1 Flash, que virou o meu modelo para quase tudo, principalmente código.
O Claude agora monta painéis (e apresentações)
Na quinta (8), a Anthropic lançou o Claude Dashboards. Você conecta o Claude às fontes de dados da empresa e pergunta do jeito que perguntaria a um colega: “como foram as inscrições desta semana comparadas com o mês passado?” ou “me mostra as oportunidades abertas no Salesforce”. Ele busca os números, monta o painel e atualiza sozinho quando os dados mudam.
Tudo isso sem escrever código e sem esperar a fila do time de dados. Dá para imaginar a coordenação de marketing acompanhando a campanha da semana, o financeiro olhando o caixa por projeto, o comercial vendo o funil e o RH acompanhando as contratações do trimestre, cada um perguntando do seu jeito.
O detalhe que eu mais gostei: cada gráfico mostra a consulta que gerou aquele número e a hora da última atualização. Clicou num número, dá para ver de onde ele veio ou pedir para o Claude explicar. Para quem precisa justificar um dado numa reunião, numa auditoria ou para um cliente, isso faz toda a diferença.
O que você precisa saber antes. O Dashboards está em fase de testes nos planos pagos (Pro, Max, Team e Enterprise) e, por enquanto, conecta com plataformas de dados como BigQuery, Snowflake, Databricks, Amazon Redshift e ClickHouse, além de apps como o Salesforce. Looker, monday.com e Tableau estão na fila. Na prática, alguém da TI precisa fazer a conexão, e nas contas de empresa o recurso vem desligado até um administrador ativar. A própria Anthropic diz que ele serve para “perguntas rápidas e exploratórias”, não para substituir as ferramentas de BI.
E para quem usa o plano grátis? No mesmo anúncio, o Claude Docs, o Slides e o Design saíram da fase de testes em todos os planos, inclusive no gratuito. Ou seja: dá para pedir ao Claude um documento, uma apresentação ou uma peça visual, editar ali mesmo (inclusive pelo celular) e exportar para PowerPoint, PDF ou Google Slides. Um parecer, uma proposta comercial, o material da aula de quinta. Segundo a empresa, já foram criados mais de 45 milhões de documentos, apresentações e designs.
Tem também animação. O Claude Motion, em testes nos planos Team e Enterprise, transforma um pedido em uma animação curta em MP4: um vídeo explicativo de 30 segundos a partir de um relatório trimestral, um gráfico que ganha movimento na apresentação para a diretoria, um passo a passo para novos clientes. Ele anima o seu próprio texto, os seus gráficos e as suas imagens, sem gerar pessoas ou cenas com IA, o que tranquiliza quem cuida de marca. Para usar, é só digitar /motion na conversa.
GPT-6 chega ao ChatGPT, inclusive no plano grátis
Na quarta (7), a OpenAI começou a liberar o GPT-6 no ChatGPT. Quem paga (Plus, Pro, Business e Enterprise) recebeu o GPT-6 Sol. No dia seguinte, os planos Free e Go ganharam o GPT-6 Luna. Ou seja: quem nunca pagou por IA também passou a usar um modelo da geração nova. Segundo a OpenAI, o ChatGPT passa de 1,2 bilhão de usuários por semana, então essa mudança chega a muita gente de uma vez.
A novidade que mais aparece no dia a dia é a Intelligent UI: em vez de responder só com texto, o ChatGPT pode montar uma pequena interface dentro da conversa. Num dos exemplos da OpenAI, o pedido de um almoço de domingo virou um plano com imagens dos pratos, uma calculadora de compras que se ajusta ao número de convidados e uma linha do tempo de preparo.
O que isso muda para você. Peça um simulador de orçamento para um evento, uma calculadora de juros para mostrar ao cliente, um checklist de boas-vindas para quem chega no time ou um quiz para a aula de amanhã, e ele monta ali mesmo, pronto para usar e mostrar. Só confira as contas: interface bonita não garante fórmula certa.
E vem anúncio por aí. A OpenAI anunciou em 5 de outubro que vai testar um formato visual de anúncio que aparece enquanto o ChatGPT gera uma imagem, por enquanto só nos Estados Unidos. A empresa promete identificação clara e diz que anúncio não influencia as respostas. Para quem usa o ChatGPT todo dia, vale aprender a separar o que é resposta do que é publicidade. Para quem anuncia, é um canal novo nascendo.
O Google colocou um agente dentro do Gmail e do Docs
Também na quinta (8), o Google Cloud apresentou o agente do Gemini para o trabalho: um assistente que responde perguntas, executa tarefas, cria conteúdo e escreve código dentro do Gmail, do Docs, do Sheets e do Agenda, e que também funciona com o Microsoft 365 e o Slack. Ele escolhe o modelo para cada tarefa e, num detalhe curioso, além do Gemini também usa os modelos Claude, da Anthropic. Há versões específicas para finanças e para jurídico em prévia, e outras para governo, saúde e varejo a caminho.
Ainda é uma prévia para empresas, sem preço nem data de lançamento geral. Mas o recado é claro: a IA vai trabalhar dentro das ferramentas que você já usa, e não numa janela separada.
E as imagens ficaram mais baratas. O Nano Banana 2.1, novo modelo de imagem do Google lançado na terça (6), custa cerca de metade do anterior por imagem e já aparece no app Gemini, no Modo IA da Busca e no Google Ads. Serve para o criativo da campanha, para o material da aula, para a ilustração do relatório. Como sempre, revise antes de publicar.
Os modelos novos, sem tecniquês
Por trás dessas funcionalidades estão os modelos, os “cérebros” que fazem o trabalho pesado. E a semana também mexeu neles.
Claude 5.5. Em pouco mais de duas semanas, a Anthropic trocou a família inteira: o Opus 5.5 (22 de setembro), o mais forte; o Sonnet 5.5 (28 de setembro), o intermediário; e o Haiku 5.5 (quarta passada, 7 de outubro), o pequeno e rápido. O Opus 5.5 lidera o ranking independente da Artificial Analysis (veja o placar mais abaixo) e, segundo a Anthropic, entrega o nível do modelo mais caro da empresa, o Fable 5.1, custando cerca de 40% menos para rodar que o Opus anterior.
Token é o pedacinho de texto que o modelo lê e escreve. Um milhão de tokens equivale, grosso modo, a mais de mil páginas de texto. É por token que as empresas cobram o uso dos modelos.
Os números que a Anthropic divulgou mostram onde o Opus 5.5 mais avançou:
| Teste | O que mede, em português claro | Opus 5.5 | Fable 5.1 | Opus 5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | entregas reais de dezenas de profissões, como análises, relatórios e planilhas (pontuação Elo, quanto maior, melhor) | 1.846 | 1.735 | 1.708 |
| Terminal-Bench 4.0 | programar e executar tarefas no computador | 66,4% | 55,8% | 52,3% |
| CursorBench 4.0 | programar dentro de um editor de código | 57,8% | 51,8% | 46,6% |
Fonte: Anthropic, via VentureBeat. Números divulgados pela própria empresa.
O teste que mais conversa com quem não programa é o primeiro, o GDPval, porque simula trabalho de verdade em várias profissões. Ali o Opus 5.5 abriu mais de 100 pontos de vantagem sobre o Fable 5.1.
Um aviso honesto. A própria Anthropic diz que as diferenças nos benchmarks já não refletem tão bem o uso real, e que na prática a distância para o Fable 5.1 parece menor do que os números sugerem. Benchmark ajuda a separar o joio do trigo, mas o teste que vale é o seu: pegue uma tarefa que você faz toda semana e compare.
O pequeno que importa. O Haiku 5.5 cobra um décimo do preço por token do antecessor (US$ 0,10 por milhão de tokens de entrada), e a Anthropic estima uma economia média de cerca de 75%. Modelos pequenos e baratos assim são os que tendem a aparecer dentro dos aplicativos do dia a dia: no atendimento, no resumo da reunião, na triagem da caixa de entrada. Quando o preço cai a esse ponto, muita empresa que achava IA cara começa a testar.
Jev, a IA que não conversa
Entre programadores, o assunto das últimas semanas foi o Jev, da startup TypeSafe AI, fundada por Diogo Almeida, ex-pesquisador da OpenAI e um dos autores do InstructGPT, o trabalho que ajudou a ensinar modelos de linguagem a seguir instruções. Apresentado em 15 de setembro e aberto para todo mundo no dia 21, ele faz o oposto do ChatGPT: não escreve nada.
Você manda um texto e as opções possíveis, e o Jev devolve a opção escolhida e o quanto ele confia em cada uma. Ele não explica, não conversa, não gera texto. A empresa chama isso de “System One”, em referência ao pensamento rápido e intuitivo descrito pelo psicólogo Daniel Kahneman.
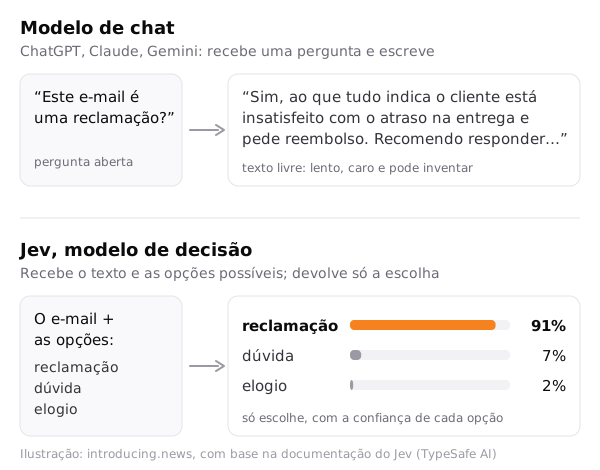
Por que isso importa fora da programação? Porque muita coisa no trabalho, no fundo, é escolha. Este e-mail é reclamação ou dúvida? Este lead é quente ou frio? Este contrato é de locação, de prestação de serviço ou outro? Este currículo vai para qual vaga? Usar um modelo que escreve parágrafos só para devolver um rótulo é caro e lento. O Jev responde em menos de meio segundo e cobra US$ 0,042 por milhão de tokens de entrada, com a saída de graça, cerca de 100 vezes menos que a entrada do Opus 5.5. A TypeSafe já captou US$ 40 milhões, e o Jev já aparece em plataformas usadas por desenvolvedores, como as da Vercel e da Cloudflare. Na prática, a tendência é ele chegar até você embutido em ferramentas de atendimento, de vendas e de triagem de documentos.
Onde ter cuidado. Uma análise detalhada publicada no blog do Fabio Akita, com testes do neurocientista Paulo Câmara, encontrou problemas que vale conhecer:
- Confiança exagerada. Num teste de risco cardíaco em que a taxa real era de 9%, o Jev atribuiu, em média, 27%. Em perguntas em que as próprias pessoas discordavam entre si, ele mantinha cerca de 81% de confiança.
- Preferência pela primeira opção. Em sorteios, em que não existe resposta certa, ele escolheu sempre a primeira opção, com 76% a 92% de certeza.
- Fácil de influenciar. Uma opinião não verificada colocada no texto derrubou o acerto de 96,5% para 26,5%.
- Privacidade. Os dados vão para os Estados Unidos, e o contrato cita regras da Europa, do Reino Unido e da Califórnia, mas não menciona a LGPD.
O próprio Paulo avisa que fundou uma empresa que concorre no mesmo mercado, então vale ler com esse desconto. Ainda assim, a conclusão é equilibrada: o Jev é uma boa ferramenta para decisões repetidas sobre texto, não uma bala de prata. A promessa de que ele “não alucina” só é verdade no sentido de que ele não consegue inventar uma resposta fora das opções. Escolher a opção errada, ele escolhe.
A regra vale para qualquer área: decisão que afeta cliente, paciente, aluno ou candidato precisa de revisão humana, e dado pessoal não deve ir para um serviço que não deixa claro como cumpre a LGPD.
O placar dos modelos
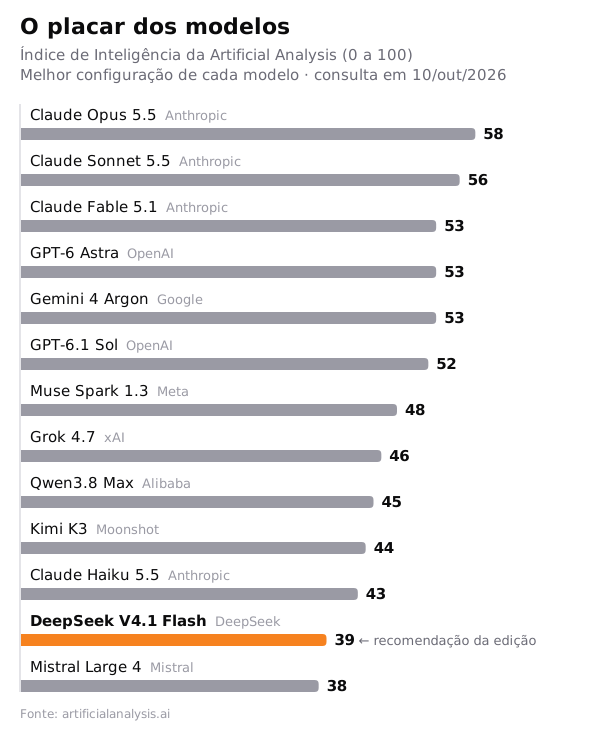
Benchmark é uma prova padronizada: todos os modelos fazem as mesmas tarefas e recebem uma nota. Para comparar os principais modelos do mercado, usamos o Índice de Inteligência da Artificial Analysis, uma organização independente que roda os testes por conta própria e junta raciocínio, conhecimento, matemática e programação numa nota de 0 a 100. Para cada modelo, mostramos a melhor configuração testada. Muitos modelos podem “pensar” mais ou menos antes de responder, e isso muda a nota e o custo.
Três coisas chamam atenção.
1. O topo está apertado. Do primeiro ao sexto colocado, a diferença é de seis pontos. A Anthropic ocupa as duas primeiras posições, e o Fable 5.1 divide o terceiro lugar com o GPT-6 Astra, da OpenAI, e o Gemini 4 Argon, do Google.
2. O preço não acompanha a nota. É aqui que a conversa fica interessante. Veja o mesmo placar cruzando a nota com o custo para resolver cada tarefa do teste:
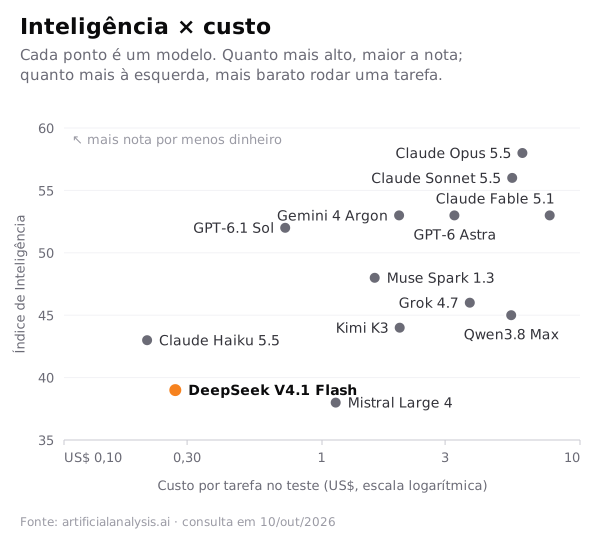
O GPT-6.1 Sol faz 52 pontos gastando US$ 0,72 por tarefa, enquanto o Opus 5.5 faz 58 gastando US$ 5,98: seis pontos a mais por mais de oito vezes o preço. Na ponta barata, o Claude Haiku 5.5 (US$ 0,21) e o DeepSeek V4.1 Flash (US$ 0,27) custam menos de 5% do que custa o Opus 5.5.
3. Velocidade também conta. No teste da Artificial Analysis, o DeepSeek V4.1 Flash começou a responder em pouco mais de 1 segundo e terminou em cerca de 13 segundos. O Opus 5.5, na configuração máxima, levou mais de 11 minutos, porque “pensa” bastante antes de responder. No dia a dia, essa diferença pesa.
| Modelo | Empresa | Nota | Custo por tarefa | Velocidade |
|---|---|---|---|---|
| Claude Opus 5.5 | Anthropic | 58 | US$ 5,98 | 96 tokens/s |
| Claude Sonnet 5.5 | Anthropic | 56 | US$ 5,46 | 141 tokens/s |
| Claude Fable 5.1 | Anthropic | 53 | US$ 7,63 | 70 tokens/s |
| GPT-6 Astra | OpenAI | 53 | US$ 3,26 | 47 tokens/s |
| Gemini 4 Argon | 53 | US$ 1,99 | sem dado | |
| GPT-6.1 Sol | OpenAI | 52 | US$ 0,72 | 56 tokens/s |
| Muse Spark 1.3 | Meta | 48 | US$ 1,60 | 175 tokens/s |
| Grok 4.7 | xAI | 46 | US$ 3,74 | 74 tokens/s |
| Qwen3.8 Max | Alibaba | 45 | US$ 5,41 | 36 tokens/s |
| Kimi K3 | Moonshot | 44 | US$ 2,00 | 41 tokens/s |
| Claude Haiku 5.5 | Anthropic | 43 | US$ 0,21 | 240 tokens/s |
| DeepSeek V4.1 Flash | DeepSeek | 39 | US$ 0,27 | 217 tokens/s |
| Mistral Large 4 (prévia) | Mistral | 38 | US$ 1,13 | sem dado |
Fonte: Artificial Analysis, consulta em 10 de outubro de 2026. Melhor configuração de cada modelo. “Custo por tarefa” é o gasto médio para resolver cada tarefa do índice; velocidade em tokens gerados por segundo.
Como usar esse placar. Nota alta não quer dizer “melhor para você”. Para revisar um contrato de 80 páginas, analisar uma pesquisa de mercado inteira ou planejar o semestre, pode valer pagar pelo topo. Para resumir reuniões, organizar planilhas, gerar variações de texto ou tirar dúvidas rápidas, um modelo do meio da tabela resolve, mais rápido e por uma fração do preço.
Minha recomendação: DeepSeek V4.1 Flash
Nas últimas semanas, o DeepSeek V4.1 Flash virou o meu modelo para quase tudo, principalmente código. Ele não é o mais inteligente do placar, e nem precisa ser. O que me ganhou foi a combinação de três coisas: é barato, é rápido e resolve.
- Barato. Na API oficial, custa US$ 0,30 por milhão de tokens de entrada e US$ 1,20 de saída no horário de pico, e metade disso fora dele. Um detalhe que pouca gente percebe: o pico da DeepSeek vai das 22h à 1h e das 3h às 7h, no horário de Brasília, de segunda a sexta. Ou seja, no horário comercial do Brasil você paga a tarifa com desconto.
- Rápido. Passa de 200 tokens por segundo no teste da Artificial Analysis, entre os mais rápidos da lista.
- Funcional. Lê até 1 milhão de tokens de uma vez (cabe um projeto inteiro ou uma pilha de documentos), aceita imagens e, no meu uso, vai muito bem com código: revisar, refatorar, escrever testes e entender código dos outros.
Como eu uso. No código, ele entra nas ferramentas de programação que aceitam modelos via API, e deixo os modelos mais caros para quando a tarefa pede muito raciocínio. Para quem não programa, dá para conhecer os modelos da DeepSeek no chat do site e do app da empresa, e usar para resumir textos longos, revisar e organizar ideias.
O cuidado que eu tomo. A DeepSeek é uma empresa chinesa e, segundo a própria política de privacidade, o que você manda pela API e pelo app oficial é processado em servidores na China. Por isso, eu não uso para nada com dado sensível de cliente, contrato confidencial ou informação pessoal. Como a DeepSeek publicou os pesos do modelo, outros provedores podem hospedá-lo fora da China (a Fireworks é um deles). Para dado sensível, prefira um desses caminhos ou um modelo com contrato e política de dados claros para a sua empresa.
Golpes, regras e responsabilidade
- Uma biblioteca pública de anúncios no Brasil. Uma portaria do Ministério da Justiça publicada em 23 de setembro obriga redes com mais de 1 milhão de usuários, como Instagram, Facebook, YouTube e TikTok, a manter um repositório público e pesquisável dos anúncios pagos: conteúdo, CPF ou CNPJ de quem pagou, período de veiculação e critérios de segmentação, guardados por pelo menos um ano. Para quem vê anúncio, é uma arma contra golpe: vai dar para pesquisar quem pagou por aquela oferta boa demais para ser verdade. Para quem anuncia, a segmentação das campanhas vai ficar visível para qualquer pessoa, inclusive para a concorrência. As plataformas têm 90 dias para colocar tudo no ar, o que leva o prazo para perto do Natal.
- IA que inventa fonte continua dando multa. Os tribunais seguem punindo petições que citam decisões inexistentes criadas por IA. Já houve multa por litigância de má-fé, inclusive no TSE, e o envio dos autos à OAB virou praxe, segundo o Conjur. O recado vale para qualquer área: relatório com dado inventado, post com estatística que não existe, trabalho com referência fantasma. Quem assina responde. Confira cada citação na fonte original antes de entregar.
- Marco Legal da IA ainda na fila. O PL 2.338/2023, que regula a IA no Brasil, ainda não foi votado na Câmara. O relator, deputado Aguinaldo Ribeiro, disse em agosto que a votação ficaria para depois das eleições. Com o segundo turno marcado para 25 de outubro, é por aí que o tema pode voltar à pauta. E, se a Câmara mudar o texto, ele volta para o Senado.
Datas para anotar
- 9 a 12 de novembro: Web Summit, em Lisboa. Um dos maiores encontros de tecnologia da Europa, com startups, investidores e grandes empresas, e muita conversa sobre IA no trabalho.
- 30 de novembro a 4 de dezembro: AWS re:Invent, em Las Vegas. A conferência anual da Amazon Web Services, de onde costumam sair as novidades de IA que depois chegam às ferramentas das empresas.
- 14 de dezembro: o site separado do Claude Design sai do ar. Quem usa o claude.ai/design deve migrar ou baixar os projetos antes; depois disso, o endereço passa a levar para o Claude normal, onde o Design já funciona.
- Por volta de 22 de dezembro: prazo da biblioteca de anúncios. É quando vencem os 90 dias para as plataformas colocarem o repositório público no ar.
O que vem por aí, aqui na introducing.news
Esta é só a primeira. Já estou planejando as próximas edições e muitas novidades junto com as pessoas que vão fazer parte desta curadoria: profissionais e pesquisadores que vivem tecnologia todos os dias, em áreas bem diferentes. Nas próximas semanas, você vai conhecer cada uma delas por aqui.
Se algum assunto desta edição deixou dúvida, ou se tem um tema que você quer ver explicado, é só responder o e-mail. Eu leio tudo.
Até segunda que vem.
Fontes
- Unite.AI: Anthropic lança Claude Dashboards e Motion e tira o Docs da fase de testes
- Reuters, via US News: Anthropic lança ferramentas de painel e animação para o Claude
- OpenAI: GPT-6 and Intelligent UI for everyone
- Unite.AI: GPT-6 com Intelligent UI em todos os planos do ChatGPT
- BleepingComputer: anúncios visuais no ChatGPT
- Reuters, via The Star: Google Cloud apresenta agente do Gemini para o trabalho
- AI Weekly: Nano Banana 2.1
- Anthropic: página do Claude Opus
- VentureBeat: Anthropic releases Claude Opus 5.5
- SiliconANGLE: Anthropic releases Claude Haiku 5.5
- TechTudo: O que é o Jev
- Fabio Akita e Paulo Câmara: Entendendo o hype do Jev
- Artificial Analysis: ranking de modelos
- DeepSeek: preços da API e relatório técnico do V4.1 Flash
- Ministério da Justiça: novas regras para publicidade digital
- Conjur: má-fé no uso de IA leva à condenação de advogados
- LCF Consulting: situação do PL 2.338/2023
Receba a próxima edição
Toda segunda, às 07:45, grátis e sem spam.
 1 min de leitura